Pourquoi l'observabilité est devenue une priorité stratégique
Les systèmes distribués modernes diffèrent en profondeur des architectures monolithiques héritées. Le logiciel d'aujourd'hui impose aux équipes DevOps de superviser efficacement leurs systèmes et de les améliorer en continu pour réduire au minimum les événements perturbateurs, d'autant que la fréquence des déploiements a explosé avec l'intégration et la livraison continues.
Deux capacités deviennent alors centrales : rendre le système observable, pour comprendre ce qui s'y passe réellement, et le rendre résilient, pour qu'il encaisse les incidents sans s'effondrer. Un système peut être surveillé sans être observable, recevoir des alertes ne dit rien sur la cause d'un problème inédit. C'est cette articulation entre observabilité et résilience que nous explorons ici, avec les pratiques et l'outillage qui, en 2026, permettent de la mettre en œuvre à l'échelle.
Des systèmes distribués aux architectures en microservices
Du monolithe au maillage de services
Les systèmes monolithiques traditionnels fonctionnaient dans des structures fortement en couches, gérées par des équipes IT internes sur des sites précis. Les systèmes distribués contemporains, eux, se composent de multiples éléments interconnectés répartis sur plusieurs environnements et plateformes : conteneurs orchestrés par Kubernetes, fonctions serverless, bases de données managées, files de messages et API tierces cohabitent dans une même chaîne de traitement.
On peut définir un système distribué comme un réseau de composants interconnectés fonctionnant ensemble comme un seul état. Cette approche permet aux entreprises d'intégrer des technologies variées tout en préservant scalabilité et résilience, mais sa complexité exige des contrats d'interface standardisés entre composants pour garantir la disponibilité, la compatibilité et la cohérence des données.
Le prix de la distribution : une complexité qui se déplace
De plus en plus d'organisations remplacent les conceptions monolithiques par des architectures en microservices. Chaque service y opère de manière indépendante dans un environnement cloud tout en restant relié aux systèmes opérationnels, ce qui autorise un déploiement et une mise à l'échelle service par service, au rythme des besoins métier.
Ce gain d'agilité a une contrepartie : la complexité ne disparaît pas, elle se déplace du code vers le réseau. Une requête qui traversait autrefois quelques appels de fonctions dans un même processus traverse désormais dix, vingt, parfois cinquante services, chacun avec sa propre latence, ses propres dépendances et ses propres modes de défaillance. On la retrouve aussi bien dans le e-commerce que dans la banque ou l'industrie manufacturière, autant de secteurs où la disponibilité et la capacité à évoluer priment.
Les trois piliers de l'observabilité
Logs, métriques et traces : des signaux complémentaires
L'observabilité désigne la capacité à comprendre l'état interne d'un système à partir des seules données qu'il expose vers l'extérieur, sans avoir à le modifier pour chaque nouvelle question qu'on se pose. Elle repose sur trois catégories de signaux qui se complètent plutôt qu'elles ne se substituent : les logs structurés, qui capturent des événements discrets avec leur contexte ; les métriques, qui agrègent des mesures numériques dans le temps pour détecter des tendances ; et les traces distribuées, qui reconstituent le parcours complet d'une requête à travers les services traversés.
Du monitoring réactif à l'investigation exploratoire
Gérer efficacement un système distribué suppose de le rendre observable au sens fort : pouvoir isoler une requête précise et identifier le composant responsable d'une anomalie, y compris pour des questions qu'on n'a pas anticipées lors de l'instrumentation. C'est la différence entre un monitoring classique, qui vérifie des hypothèses connues à l'avance via des tableaux de bord figés, et une observabilité mature, qui permet d'explorer librement des données à haute cardinalité pour formuler de nouvelles hypothèses en pleine crise.
Outiller le tracing distribué et la corrélation des signaux
OpenTelemetry comme socle commun
L'instrumentation s'est standardisée autour d'OpenTelemetry, qui unifie la collecte de logs, métriques et traces derrière une API et un protocole communs, indépendants du fournisseur d'observabilité choisi en aval. Chaque service propage un identifiant de trace et un identifiant de span à travers ses appels sortants, ce qui permet de reconstituer, service par service, le chemin exact suivi par une requête et d'isoler le maillon qui introduit la latence ou l'erreur.
Corréler pour raccourcir le temps de diagnostic
L'enjeu, une fois les données collectées, est la corrélation : relier une trace lente à la version de code déployée, au nœud Kubernetes concerné, à l'événement de scaling qui a précédé l'incident. Les plateformes d'observabilité modernes automatisent cette corrélation et réduisent le temps moyen de diagnostic, ce qui pèse directement sur le temps moyen de résolution, un des indicateurs les plus scrutés par les équipes SRE.
Concevoir la résilience : patterns et anti-patterns
Les patterns qui absorbent la défaillance
La résilience désigne la capacité d'une application à retrouver ses conditions de fonctionnement antérieures après un événement adverse ou une défaillance. Elle ne consiste pas seulement à éviter les pannes, mais à préparer et gérer ces événements pour revenir ensuite au protocole standard. Concrètement, elle s'appuie sur un jeu de patterns éprouvés : le circuit breaker, qui coupe les appels vers un service défaillant plutôt que de les laisser s'accumuler ; le retry avec backoff exponentiel et jitter, qui évite les tempêtes de nouvelles tentatives synchronisées ; le bulkhead, qui isole les pools de ressources pour qu'une saturation locale ne contamine pas le reste du système ; et le timeout, trop souvent négligé, qui borne le temps d'attente d'un appel distant.
Valider la résilience par l'expérimentation
Ces patterns ne suffisent pas s'ils ne sont jamais testés en conditions réelles. Le chaos engineering, l'injection contrôlée de pannes en production ou en pré-production, est devenu la méthode de référence pour vérifier qu'un système se comporte comme prévu quand un nœud tombe, qu'une zone de disponibilité devient inaccessible ou qu'une dépendance externe répond avec dix fois sa latence habituelle.
L'architecture pilotée par les événements comme filet de sécurité
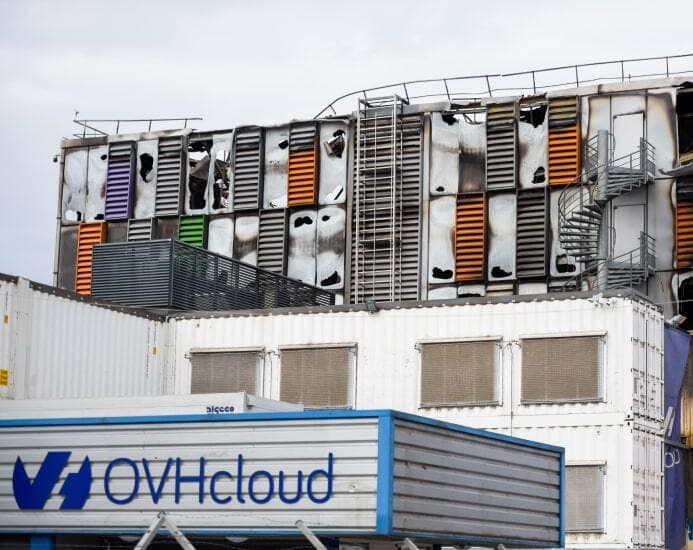
Dans un système distribué, la résilience se construit à l'échelle des composants, pas seulement à celle de l'application globale. L'architecture pilotée par les événements y contribue directement : en remplaçant les appels synchrones bloquants par des files de messages et des flux d'événements, elle apporte une forme de sûreté en permettant qu'un système individuel tombe sans compromettre le fonctionnement de l'ensemble.
Un service producteur publie un événement et poursuit son traitement sans attendre que le consommateur l'ait traité ; si ce consommateur est temporairement indisponible, le message reste dans la file jusqu'à ce qu'il puisse le récupérer, sans perte ni blocage en cascade. Cette forme de découplage temporel réduit mécaniquement la surface d'impact d'une panne isolée et facilite l'absorption des pics de charge grâce au tampon naturel que constitue la file.
Piloter par les SLI, les SLO et la culture SRE
Observer un système ne suffit pas à en piloter la fiabilité : il faut traduire les signaux collectés en objectifs mesurables et partagés avec le métier. Les indicateurs de niveau de service (SLI) mesurent une dimension concrète de l'expérience utilisateur, latence, taux d'erreur, disponibilité, tandis que les objectifs de niveau de service (SLO) fixent le seuil acceptable sur une fenêtre de temps donnée, généralement de l'ordre de 99,9 % pour un service critique.
L'écart entre l'objectif et la performance réelle constitue le budget d'erreur : tant qu'il n'est pas consommé, l'équipe peut prendre des risques raisonnés, déployer plus souvent, expérimenter de nouvelles fonctionnalités. Dès qu'il s'épuise, la priorité bascule mécaniquement vers la stabilisation. Cette discipline, portée par les équipes SRE, remplace la course binaire au zéro incident par un arbitrage continu et documenté entre vélocité et fiabilité.
Faire cohabiter observabilité et résilience avec Adservio
Faire cohabiter observabilité et résilience relève autant de la méthode que de l'outillage. Une stack technique complète, OpenTelemetry, un backend de traces, un moteur d'alerting corrélé aux SLO, ne produit de valeur que si elle est adossée à des runbooks clairs, à des exercices de chaos engineering réguliers et à une culture de post-mortem sans reproche qui capitalise sur chaque incident.
Chez Adservio, nous accompagnons les organisations dans la mise en place de ces pratiques sur leurs systèmes distribués, en les adaptant à la réalité de chaque projet, à sa criticité métier et à sa maturité DevOps, et en écartant les pièges et anti-patterns coûteux, instrumentation excessive qui noie le signal utile, alerting mal calibré qui épuise les équipes d'astreinte, ou résilience pensée après coup plutôt qu'intégrée dès la conception.
RÉCUPÉRER CET ARTICLE
Téléchargez l'article complet en PDF pour le lire hors ligne ou le partager.
RESTER INFORMÉ
Recevez nos prochaines analyses et retours d'expérience directement dans votre boîte mail.