
Comment les agents IA changent-ils la productivité ?
Qu'ont réellement changé les agents IA dans le quotidien des équipes de développement ? Les organisations les plus avancées dans leur adoption offrent aujourd'hui un premier aperçu des défis et des opportunités qui attendent l'ensemble de l'écosystème logiciel.
INSIGHTS ADSERVIO · STRATÉGIE IA
EN BREF
- Une explosion mécanique du volume de code : les développeurs adoptant un agent de développement génèrent 153 % de commits supplémentaires, c'est-à-dire d'enregistrements de code, selon une étude du NBER menée auprès de 521 329 développeurs. Pour autant, l'accélération perçue par les équipes dépasse souvent les gains d'efficacité réels.
- Une déperdition le long de la chaîne de valeur : au sein de cette même cohorte, le volume de versions publiées ne progresse que de 20 %. Sur l'ensemble de l'App Store, le nombre d'applications publiées chaque mois a presque triplé, sans hausse de leur usage total.
- Un levier conditionné par le niveau d'expertise : aux commandes d'un agent, un développeur expérimenté réussit deux fois plus souvent qu'un profil débutant. C'est l'intégration de l'IA au cœur des processus d'ingénierie, bien plus que le choix de l'outil, qui fait la différence.
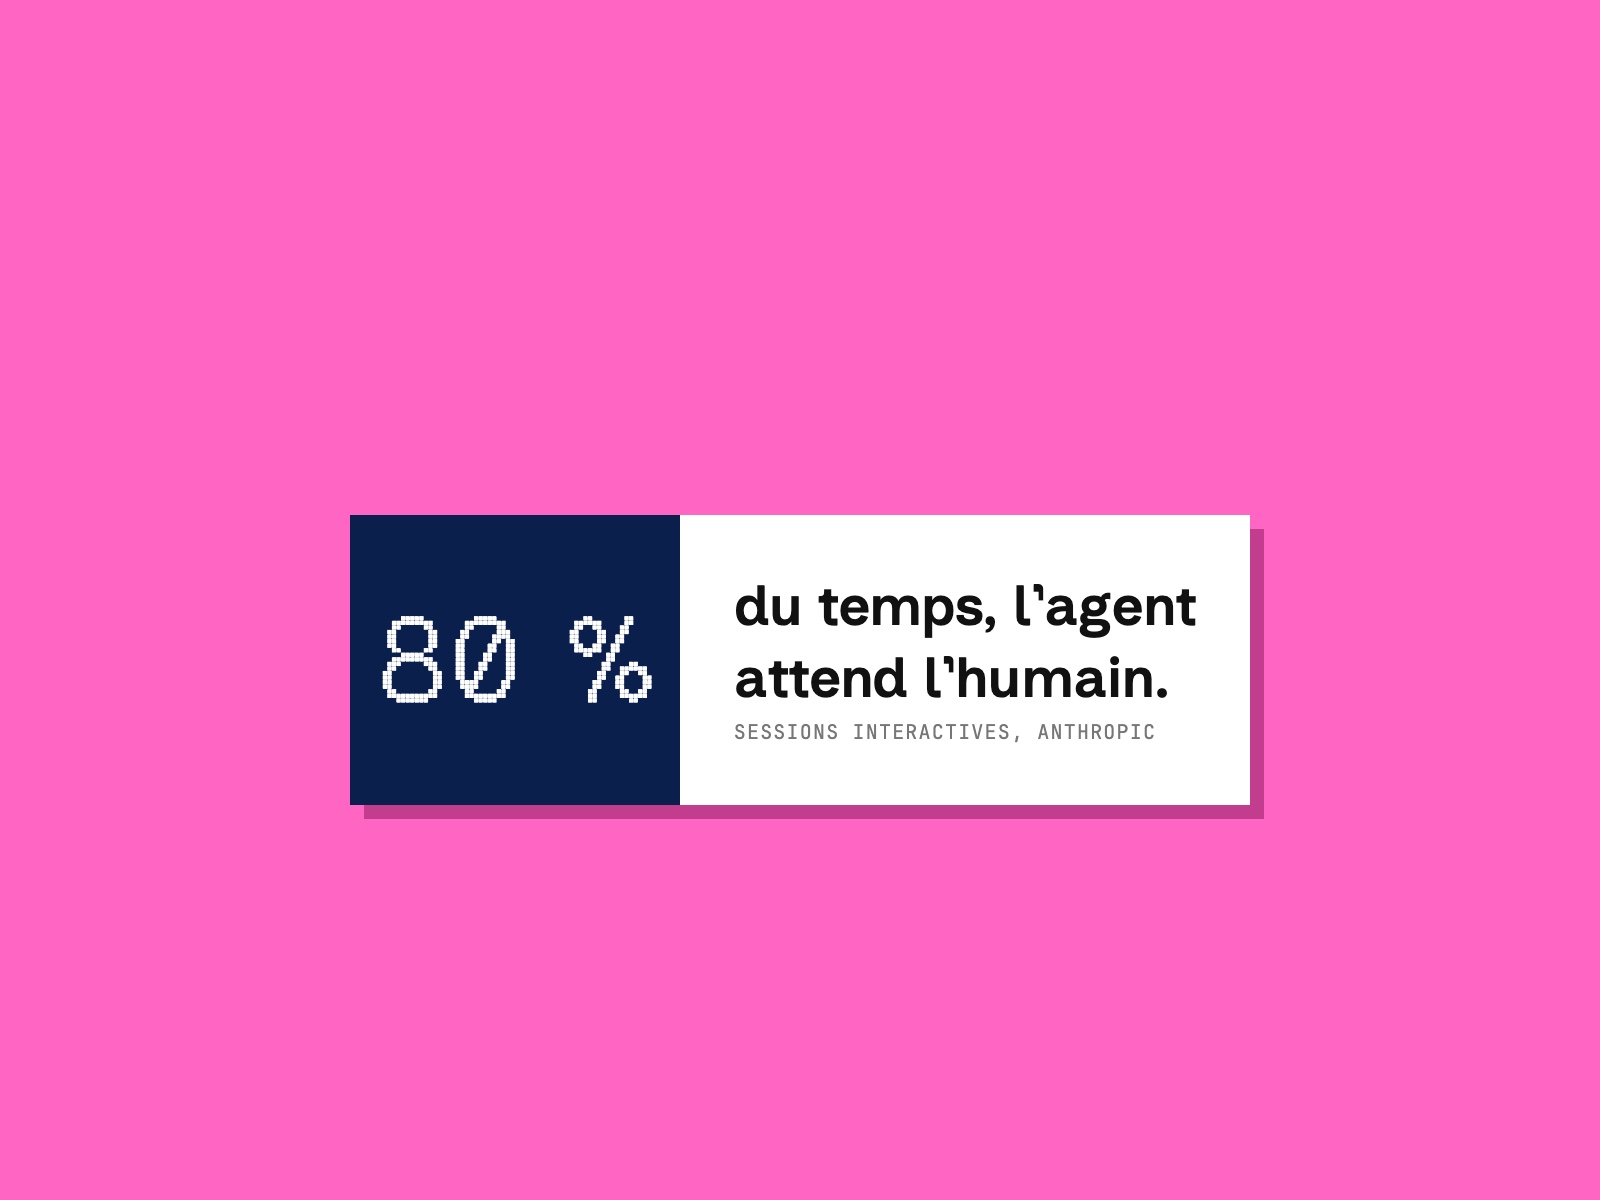
- L'attention humaine comme nouveau goulet d'étranglement : chez Anthropic, les agents interactifs passent environ 80 % de leur temps à attendre un arbitrage humain. La délégation n'est véritablement rentable que sur les tâches faciles à vérifier.
SECTION 1
Des métriques qui ne mesurent pas la même réalité
Des tâches bouclées en quatre fois moins de temps, cinq fois plus de commits, huit fois plus de code fusionné : sur les agents IA, les chiffres abondent, et la plupart sont exacts. Ils ne mesurent pourtant pas la même chose. Le premier traduit un ressenti, le deuxième un volume de code écrit, le troisième du code accepté dans le projet. Aucun ne dit encore combien de logiciel arrive réellement en production, ni s'il est utilisé. Pour une DSI qui doit arbitrer ses investissements, c'est pourtant la question décisive.
En 2026, la recherche mesure enfin l'impact propre des agents de développement, capables d'écrire, de tester et de corriger des fonctionnalités complètes, et non plus seulement celui de l'autocomplétion. Nous avons choisi de partir de ces mesures à grande échelle, celles du NBER, l'institut américain de recherche économique, de METR, un laboratoire indépendant qui évalue l'IA, et d'Anthropic.
C'est aussi notre approche d'ingénierie : mesurer avant d'affirmer, et distinguer le gain sur la tâche du gain sur le logiciel livré. Nous lisons les études avec cette grille : ce qu'elles mesurent vraiment, sur quelle population, et ce qui reste valable hors du contexte étudié. Les publications d'Anthropic sont éclairantes, mais elles décrivent une entreprise singulière, qui conçoit elle-même ses modèles : nous en signalons les spécificités à chaque fois.
Notre objectif à travers cette analyse est de suivre le gain réel depuis l'exécution de la tâche unitaire jusqu'au produit livré à l'utilisateur, d'identifier les profils qui en bénéficient concrètement, de comprendre la mutation du travail d'ingénierie et d'établir un cadre rigoureux de délégation aux agents.
Cet article s'inscrit dans notre dossier de référence : « Ingénierie augmentée : ce qui change vraiment ». Les enjeux relatifs à la qualité intrinsèque du code généré, aux paliers d'autonomie des agents et à la refonte organisationnelle des équipes font l'objet d'analyses dédiées.
SECTION 2
Sur la tâche élémentaire, le gain d'écriture est incontestable
L'évaluation empirique la plus robuste à ce jour émane de chercheurs du MIT et de Wharton. Publiée par le NBER en mai 2026 et mise à jour en septembre, elle suit une cohorte de 521 329 développeurs sur GitHub et compare trois vagues successives d'outillage. La figure ci-dessous montre la hausse des commits pour chacune.
Figure interactive : à consulter dans la version en ligne de l'article
Les auteurs observent que ces gains grandissent surtout avec les progrès des modèles d'IA, bien davantage qu'avec l'apprentissage des développeurs.
Les observations internes partagées par Anthropic corroborent cette accélération brute. Dès août 2025, ses équipes d'ingénierie déclaraient un gain de productivité de 50 % (contre 20 % l'année précédente), adossé à une hausse de 67 % des pull requests fusionnées, les propositions de code soumises à relecture, par ingénieur et par jour. Les ingénieurs indiquaient également que 27 % du travail mené avec Claude n'aurait jamais vu le jour sans lui, typiquement de l'outillage interne ou des correctifs mineurs longtemps ajournés. En octobre 2026, l'éditeur constatait des commits par ingénieur cinq fois plus nombreux que six mois plus tôt, ainsi qu'une hausse de la production hors technique : plus de contrats traités par les juristes, plus de factures par la comptabilité, plus de ventes conclues.
Néanmoins, ces indicateurs quantifient une activité brute : du code rédigé, des tâches traitées. Ils attestent d'une capacité de production fortement accrue, mais ne démontrent pas encore une livraison accrue de valeur métier. Pour les assistants de code, nous estimions dans un précédent article l'apport net en équipe entre 5 et 15 % ; les agents changent d'échelle sur le volume de code écrit, sans transformer au même rythme le volume de fonctionnalités mises en service.
À lire aussi À quelle vitesse les assistants de codage IA accélèrent-ils vraiment la livraison logicielle ?
SECTION 3
Le piège cognitif : une vitesse perçue supérieure à la vitesse réelle
L'expérimentation contrôlée menée par METR en juillet 2025 avait mis en lumière ce paradoxe : des développeurs chevronnés étaient 19 % plus lents lorsqu'ils utilisaient l'IA, tout en ayant l'intime conviction d'avoir été 20 % plus rapides. Le suivi publié en février 2026 n'a pas pu refaire la mesure : une grande partie des participants refusaient désormais de travailler sans IA, ce qui empêchait toute comparaison.
Le ressenti varie aussi fortement selon qui répond. En août 2026, Anthropic a posé la même question à 1 334 de ses salariés et à un échantillon de près de 11 000 adultes, dont une partie utilise l'IA au travail : combien de temps prend, avec l'IA, une tâche qui s'y prête bien, comme résumer un document ou rédiger un email, vérification et corrections comprises ? Ce n'est pas une mesure de vitesse, mais une comparaison de perceptions entre ceux qui fabriquent ces outils et ceux qui les utilisent au quotidien.
Figure interactive : à consulter dans la version en ligne de l'article
Les réponses se renversent. Les salariés d'Anthropic sont plus de deux fois plus nombreux à dire gagner beaucoup de temps. À l'inverse, pour près d'un tiers des autres utilisateurs, la vérification et les corrections effacent tout le temps gagné, contre 5 % chez Anthropic.
Anthropic appelle elle-même à la prudence sur ses propres chiffres. L'un de ses rapports relève un volume de code fusionné par ingénieur huit fois supérieur à celui de 2024, mais qualifie ce chiffre de « presque certainement une surestimation du gain réel de productivité ». Son étude sur l'évolution de ses emplois conclut sans ambiguïté : « More code does not necessarily mean better code or business impact. »
Ce qu'il faut retenir
Le volume de code produit et le sentiment d'accélération éprouvé par les équipes ne sont pas des indicateurs fiables de productivité. Ils peuvent croître de manière spectaculaire sans que le logiciel effectivement livré en production progresse dans les mêmes proportions.
SECTION 4
Du code écrit au logiciel utilisé : l'effet d'entonnoir
L'étude du NBER suit la transmission du gain le long du cycle de développement, depuis l'écriture du code jusqu'à la publication. Pour les développeurs épaulés par un agent interactif, l'écart entre l'amont et l'aval est saisissant : si le volume de commits bondit de 153 % et les pull requests de 86 %, le nombre de projets actifs ne progresse que de 47 %, et le volume de versions effectivement publiées ne progresse que de 20 %. Les auteurs retiennent 153 % pour les commits ; une méthode de comparaison plus prudente donne encore 85 %.
Cet amortissement s'observe aussi sur les plateformes de distribution grand public. Sur l'App Store, le flux mensuel de nouvelles applications iOS passe d'environ 33 000 à 45 000 à près de 108 000 titres, sans hausse de l'usage total. Dans le même temps, la part des applications publiées sans audience passe de 78 % à 87 %. Les chercheurs en tirent un enseignement fondamental : les gains observés sur la tâche élémentaire ne se convertissent que partiellement en logiciel livré et utilisé. La contrainte semble se déplacer de l'écriture du code vers sa revue, son intégration et sa distribution.
Figure interactive : à consulter dans la version en ligne de l'article
Sur le plan de la qualité, les mesures disponibles n'indiquent pas de dégradation : la part des commits dédiés à la correction d'anomalies reste stable dans la cohorte du NBER. De même, chez Anthropic, à auteur, mois et projet constants, le code écrit par un agent n'est ni plus supprimé ni plus annulé que le code écrit à la main. Les auteurs rappellent toutefois que les erreurs introduites par une IA peuvent être plus difficiles à repérer à la relecture. Nous traitons la dette technique du code généré dans Code généré par l'IA : pourquoi « ça marche » ne veut pas dire « c'est maintenable ».
À lire aussi Y a-t-il encore une place pour l'agilité avec l'AI-DLC ?
SECTION 5
La prime à la compétence : l'expertise comme facteur différenciant
En juin 2026, Anthropic a analysé environ 400 000 sessions menées sur Claude Code par quelque 235 000 utilisateurs, entre octobre 2025 et avril 2026. La répartition des responsabilités y est nette : les utilisateurs prennent environ 70 % des décisions de planification, ce qu'il faut faire et comment l'aborder, tandis que l'agent prend 80 % des décisions d'exécution. Les auteurs résument ce partage en une phrase : « People decide what to build, and the agent decides how to build it. »
Pour autant, le résultat dépend directement du niveau d'expertise de celui qui pilote. Le taux de succès vérifié, c'est-à-dire les sessions qui aboutissent avec une preuve, comme des tests qui passent ou du code enregistré, n'atteint que 15 % chez les novices, contre 28 à 33 % dès le niveau intermédiaire. Face à une session en difficulté, les novices abandonnent dans 19 % des cas, contre 5 à 7 % pour les profils plus expérimentés. Ces derniers formulent des consignes plus longues et plus précises. Les agents ne remplacent pas l'expertise métier : ils en amplifient l'effet.
Les recrutements suivent le même mouvement. Chez Anthropic, les évaluations d'entretien des postes techniques valorisent de plus en plus l'autonomie et le jugement des candidats.
SECTION 6
La recomposition du temps de travail et l'essor du « méta-travail »
Dès lors que la contrainte migre vers la revue et l'intégration, c'est le quotidien des équipes qui se trouve redéfini. L'étude publiée par Anthropic en octobre 2026 sur sa propre organisation offre un premier terrain d'observation : au cours des sessions interactives, celles où un salarié travaille en direct avec Claude, les agents passent environ 80 % de leur temps à attendre une validation ou un arbitrage humain. Pour les métiers non techniques, lire l'ensemble des livrables produits par leurs sessions avec Claude mobiliserait plus de la moitié de la semaine de travail. L'attention humaine devient le véritable facteur limitant.
Une part grandissante du travail consiste donc à organiser et contrôler l'activité des agents : rédiger leurs consignes, faire relire le travail d'un agent par un autre, surveiller les chaînes automatisées. Ce « méta-travail » a plus que doublé en six mois, passant de 10 % à 22 % des sessions interactives, tandis que le nombre de consignes écrites pour les agents est passé de quelques centaines à 8 500 en un an. Dans le même temps, le temps passé en réunion par le salarié médian a progressé de 20 % : l'arbitrage et la coordination restent humains.
Figure interactive : à consulter dans la version en ligne de l'article
Anthropic présente les particularités d'un concepteur de modèles en hypercroissance, et ses auteurs préviennent que beaucoup de ses pratiques ne se reproduisent pas ailleurs. Un enseignement vaut pourtant au-delà de son cas : lorsque la production de code s'accélère, c'est la capacité à arbitrer, vérifier et coordonner qui fixe la vitesse réelle d'une organisation.
SECTION 7
La matrice d'arbitrage : la règle de l'effort de vérification
Entre autonomie intégrale et contrôle de chaque ligne, les ingénieurs d'Anthropic interrogés en 2025 donnent un critère simple. L'un d'eux le formule ainsi : l'agent est remarquable « for everything where validation effort isn't large in comparison to creation effort ». Plus il est facile de vérifier un résultat par rapport à l'effort de le produire, plus la délégation est rentable.
Croisé avec le risque d'une erreur, ce critère dessine une frontière opérationnelle claire. La grille ci-dessous permet de l'appliquer à vos propres tâches.
Figure interactive : à consulter dans la version en ligne de l'article
Même dans une entreprise où les ingénieurs utilisent Claude pour 59 % de leur travail, plus de la moitié d'entre eux déclarent ne pouvoir déléguer entièrement que 0 à 20 % de leurs tâches. S'y ajoute un paradoxe : superviser un agent avec exigence requiert précisément les compétences que l'on risque d'éroder par un excès de délégation. Les niveaux d'autonomie à accorder aux agents, et les contrôles qui vont avec, sont détaillés dans Agents IA : 40 % des entreprises pourraient les brider ou les retirer d'ici 2027.
SECTION 8
La performance découle de l'organisation, non de l'outil
Une étude de la Harvard Business School, publiée en juin 2026, porte sur 2 891 jeunes entreprises de l'accélérateur Y Combinator. Ces structures sont très différentes d'une DSI de grand groupe, mais un résultat mérite d'être retenu : la simple dotation en licences individuelles, ChatGPT, Copilot ou Cursor, ne fait pas de différence mesurable sur la structure de l'entreprise. Seules celles qui repensent leur produit et leurs processus autour de l'IA fonctionnent avec moins de salariés et moins de niveaux hiérarchiques. Les auteurs concluent que capter la valeur de l'IA demande « souvent de reconcevoir les processus autour d'elle ».
Une étude du NBER sur 3 454 entreprises cotées observe dans le même sens que l'adoption de l'IA s'accompagne d'une réduction des niveaux hiérarchiques, l'outil reprenant une part de la résolution de problèmes. Les auteurs précisent qu'il s'agit d'une corrélation, pas d'un lien de cause à effet.
Ce constat renvoie aux analyses de Daron Acemoglu et Pascual Restrepo, en 2019, sur l'automatisation dite « so-so » : une technologie qui remplace du travail humain avec un faible gain de productivité. Plaquer un agent sur un processus d'ingénierie inchangé en serait une illustration contemporaine.
SECTION 9
Piloter par la valeur livrée plutôt que par l'illusion du volume
Puisque l'appréciation subjective surévalue souvent le rendement de l'IA, le pilotage d'une DSI doit se recentrer sur ce qui arrive réellement en production. Les éditeurs outillent désormais la mesure de l'usage et des coûts, à l'image des rapports lancés par Anthropic pour Claude Enterprise le 28 octobre 2026. Ces indicateurs d'activité doivent être croisés avec des métriques de livraison objectives : fréquence de déploiement, délai entre le commit et la mise en production, taux d'échec des changements, et adoption réelle par les utilisateurs finaux.
SECTION 10
Nos cinq recommandations pour les DSI
- Mesurer la valeur livrée plutôt que le volume produit : suivre les fonctionnalités actives en production et leur usage effectif, plutôt que le nombre de lignes de code ou de commits.
- Arbitrer selon l'effort de vérification : déléguer largement ce qui se teste facilement, et garder la maîtrise de la conception, de l'architecture et des règles métier.
- Renforcer l'expertise et la rigueur de revue : les gains profitent d'abord aux ingénieurs capables de spécifier avec précision et de relire sans complaisance ; c'est sur ces compétences que l'effort de formation doit porter.
- Refondre les processus amont avant d'acquérir des licences : un outil seul ne transforme rien ; c'est la qualité des exigences et la fluidité de la chaîne d'intégration qui libèrent la valeur.
- Préserver l'attention des équipes : limiter le nombre d'agents lancés en parallèle, et formaliser par écrit le contexte et les décisions pour que les agents travaillent sur des consignes sans ambiguïté.
SECTION 11
La doctrine Adservio : un agent amplifie la chaîne telle qu'elle est
Les données convergent : les agents multiplient le code écrit, mais c'est la maturité de l'organisation qui détermine la part de ce code qui devient du logiciel utile.
Un agent n'accélère pas un projet dans l'absolu ; il accélère la chaîne de livraison telle qu'elle est, avec ses forces comme ses faiblesses. Lorsque le cadrage fonctionnel est flou, les tests instables et les revues déjà saturées, l'agent engorge le système et accumule de la dette technique.
Pour Adservio, la réussite ne commence pas au déploiement de l'outil, mais par la vérifiabilité de ce qu'il produit. Collectif d'experts en ingénierie augmentée, nous appliquons ce principe dans notre démarche AI-DLC, le cycle de développement piloté par l'IA :
- des exigences exécutables, écrites avec les équipes métier ;
- des tests dérivés du comportement attendu du système, et non du code généré ;
- des barrières de qualité bloquantes dès le commit ;
- une vérification continue en production, sur les parcours utilisateurs réels.
Nos ingénieurs interviennent au cœur de vos équipes pour piloter les agents à vos côtés sur vos projets, et aligner l'automatisation sur ce qui crée une valeur mesurable. Notre approche est détaillée sur notre page dédiée.
Passer à l'action
Votre chaîne de livraison est-elle prête pour les agents ?
Nous regardons avec vous où le gain se perd, entre le code écrit et le logiciel utilisé.
Parler à un expert : adservio.fr/contact
SECTION 12
Synthèse
Les agents ouvrent une ère d'abondance dans la production de code, mais ce gain s'effrite à mesure que l'on se rapproche du produit livré et adopté. Le succès n'est pas une question d'outillage : il repose sur l'expertise de ceux qui pilotent, la qualité des mécanismes de vérification et d'arbitrage, et la capacité à reconcevoir les processus d'ingénierie autour de l'attention humaine. Gagner en productivité à l'ère des agents est possible, à condition d'évaluer la performance là où elle se joue réellement.
FAQ
Questions fréquentes
Les agents IA augmentent-ils vraiment la productivité des développeurs ?
Sur la tâche, oui : selon une étude du NBER sur plus de 500 000 développeurs, les commits augmentent de 153 % après l'adoption d'un agent de développement. Mais les versions publiées n'augmentent que de 20 %. Le gain est réel sur l'écriture du code, beaucoup plus limité sur le logiciel livré.
Pourquoi les équipes se sentent-elles plus rapides qu'elles ne le sont ?
Parce que l'écriture du code va plus vite, alors que la vérification, les corrections et l'intégration prennent du temps. Dans l'expérience de METR, des développeurs expérimentés ont été 19 % plus lents avec l'IA tout en se pensant 20 % plus rapides.
Quelles tâches confier à un agent IA ?
Celles qui sont faciles à vérifier par rapport à l'effort de les produire, peu risquées et bien délimitées : tests, documentation, corrections mineures, outillage interne. La conception, l'architecture et les décisions métier restent humaines.
Les agents IA dégradent-ils la qualité du code ?
Les mesures disponibles ne montrent pas de dégradation : la part des corrections de bugs reste stable dans l'étude du NBER, et chez Anthropic le code écrit par un agent n'est pas plus souvent supprimé ou annulé. Les erreurs d'IA peuvent toutefois être plus difficiles à repérer, d'où l'importance de la revue et des tests.
Faut-il être expert pour bien utiliser un agent de développement ?
L'expertise fait une grande différence. Selon Anthropic, le taux de succès vérifié est de 15 % chez les novices, contre 28 à 33 % à partir d'un niveau intermédiaire, et les novices abandonnent trois fois plus souvent les sessions en difficulté.
Comment mesurer la productivité apportée par l'IA ?
En mesurant ce qui est livré et utilisé plutôt que le volume de code : fonctionnalités mises en production, délai, fiabilité, usage. Les rapports d'usage et les sondages fournis par les éditeurs sont utiles, à condition de les croiser avec ces indicateurs.
SOURCES
Mert Demirer, Leon Musolff, Liyuan Yang, « Writing Code vs. Shipping Code: Productivity Effects Across Generations of AI Coding Tools », NBER Working Paper 35275, mai 2026, révisé en septembre 2026 : https://doi.org/10.3386/w35275
METR, « Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity », 10/07/2025 : https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR, mise à jour du 24/02/2026 : https://metr.org/blog/2026-02-24-uplift-update/
Anthropic, Szymon Sacher et al., « The AI expectations gap », 16/10/2026 : https://www.anthropic.com/research/ai-expectations-gap
The Anthropic Institute, Nathan Wilmers et al., « How Employment is Changing at Anthropic », 16/10/2026 : https://www.anthropic.com/research/employment-at-anthropic
The Anthropic Institute, Marina Favaro et Jack Clark, « When AI Builds Itself », 2026 : https://www.anthropic.com/institute/recursive-self-improvement
Anthropic, Zoe Hitzig et al., « Agentic coding and persistent returns to expertise », 16/06/2026 : https://www.anthropic.com/research/claude-code-expertise
Anthropic, Saffron Huang et al., « How AI Is Transforming Work at Anthropic », 02/12/2025 : https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Hyunjin Kim et Rembrand Koning, « AI-Native Firms », Harvard Business School Working Paper 26-090, juin 2026 : https://www.hbs.edu/ris/Publication%20Files/26-090_96f92aa0-37d9-4789-beaa-5c0cb87a4032.pdf
Michael Ewens et Xavier Giroud, « Corporate Hierarchy », NBER Working Paper 34162, 2025, révisé en 2026 : https://doi.org/10.3386/w34162
Daron Acemoglu et Pascual Restrepo, « Automation and New Tasks: How Technology Displaces and Reinstates Labor », Journal of Economic Perspectives, 33 (2), 2019 : https://doi.org/10.1257/jep.33.2.3
Anthropic, « Smart reports, surveys, and pooled group budgets for Claude Enterprise », 28/10/2026 : https://claude.com/fr/resources/articles/smart-reports-surveys-pooled-budgets
À PROPOS D'ADSERVIO
Adservio est un collectif d'experts en ingénierie augmentée : DSI augmentée par l'IA, ingénierie logicielle, DevOps, MLOps, cybersécurité et gouvernance IA.
Discutons de votre projet : hello@adservio.fr · adservio.fr/contact